
面对同一个提示词,模型可以给出许多不同的回答。 TensorCash 的妙处解释了与链绑定的随机性如何将普通推理变成独一无二的候选区块。 Proof v4 在此基础上更进一步:让每个区块的难度反映其证明背后的采样行为。
目标很直接:让普通推理的成本接近现有水平,同时提高某些优化方式的成本。
考虑两个请求:数到 100,或者生成 200 次抛硬币的结果。前者要求一个可预测的序列,后者要求随机性。 仅凭这两个请求本身,都无法说明模型承担了有难度的任务。奖励推理的协议,需要考察答案长度和随机性含量之外的东西。
Proof v3 通过硬性门限判断证明是否具备资格。Proof v4 保留这些门限,并根据积分在生成过程中的累积方式, 引入逐步上升的定价。某些采样模式会在触及拒绝边界之前,先变得更昂贵。
我们把这个价格称为智能倍率。
是否有用,取决于具体任务。协议衡量的是每个验证者都能核验的生成特征,同时让用户自由选择提示词。
在全部 256 个生成步中,验证者都会根据模型自身的概率分布,保守地计算被选中 token 的意外程度。 这就是该步的积分(credit)。现有的分档规则使用积分总量;v4 还会考察积分在整个窗口中的分布, 以及采样概率分布本身的结构:
- 积分何时到来。 相对于窗口的积分总量,如果积分明显集中在较晚的步骤,或尾段之前的积分过少,倍率就会上升。
- 多少积分集中在尾段。 如果积分大量集中在最后 64 或 32 步,倍率会进一步上升。
- 采样受到多大限制。 结构因子会考虑近乎确定的生成步和重复的采样状态。近乎确定的步数过多会提高倍率; 256 步中若有 175 步或更多近乎确定,整个窗口就会被直接拒绝。
这些因子共同决定合格证明的倍率,范围为 1× 到 12×。区块头的目标值会除以这个倍率。 倍率为 2× 时,目标值减半,因此找到合格区块头所需的平均尝试次数约为原来的两倍。
验证者根据证明中的采样数据推导倍率。矿工不能自行选择或声明自己的倍率。
这套设计也必须适用于普通推理。如果一条规则虽然抑制了贴着边界做优化的行为,却经常拒绝正常任务, 或让它们的成本高得难以承受,那它的价值也就十分有限。
我们用两类样本评估了这条规则。
第一类是诚实提示词样本库:81 组提示词,共 995 个合格窗口,涵盖分析、代码、说明性写作和叙事任务。 提示词长度从 64 到 4,096 个 token 不等,在两类 GPU 上进行了七次生成运行。这是用于筛选该规则的开发样本。
第二类是从创世区块到 2026 年 9 月 12 日的全部 26,406 个主网区块的快照, 我们使用已实现的 v4 定价函数对它们进行评分。
主网结果属于反事实评估:它们展示的是,如果当时应用这条规则,会施加怎样的倍率,或拒绝哪些区块。 这些区块实际是在此前的规则下生成的。
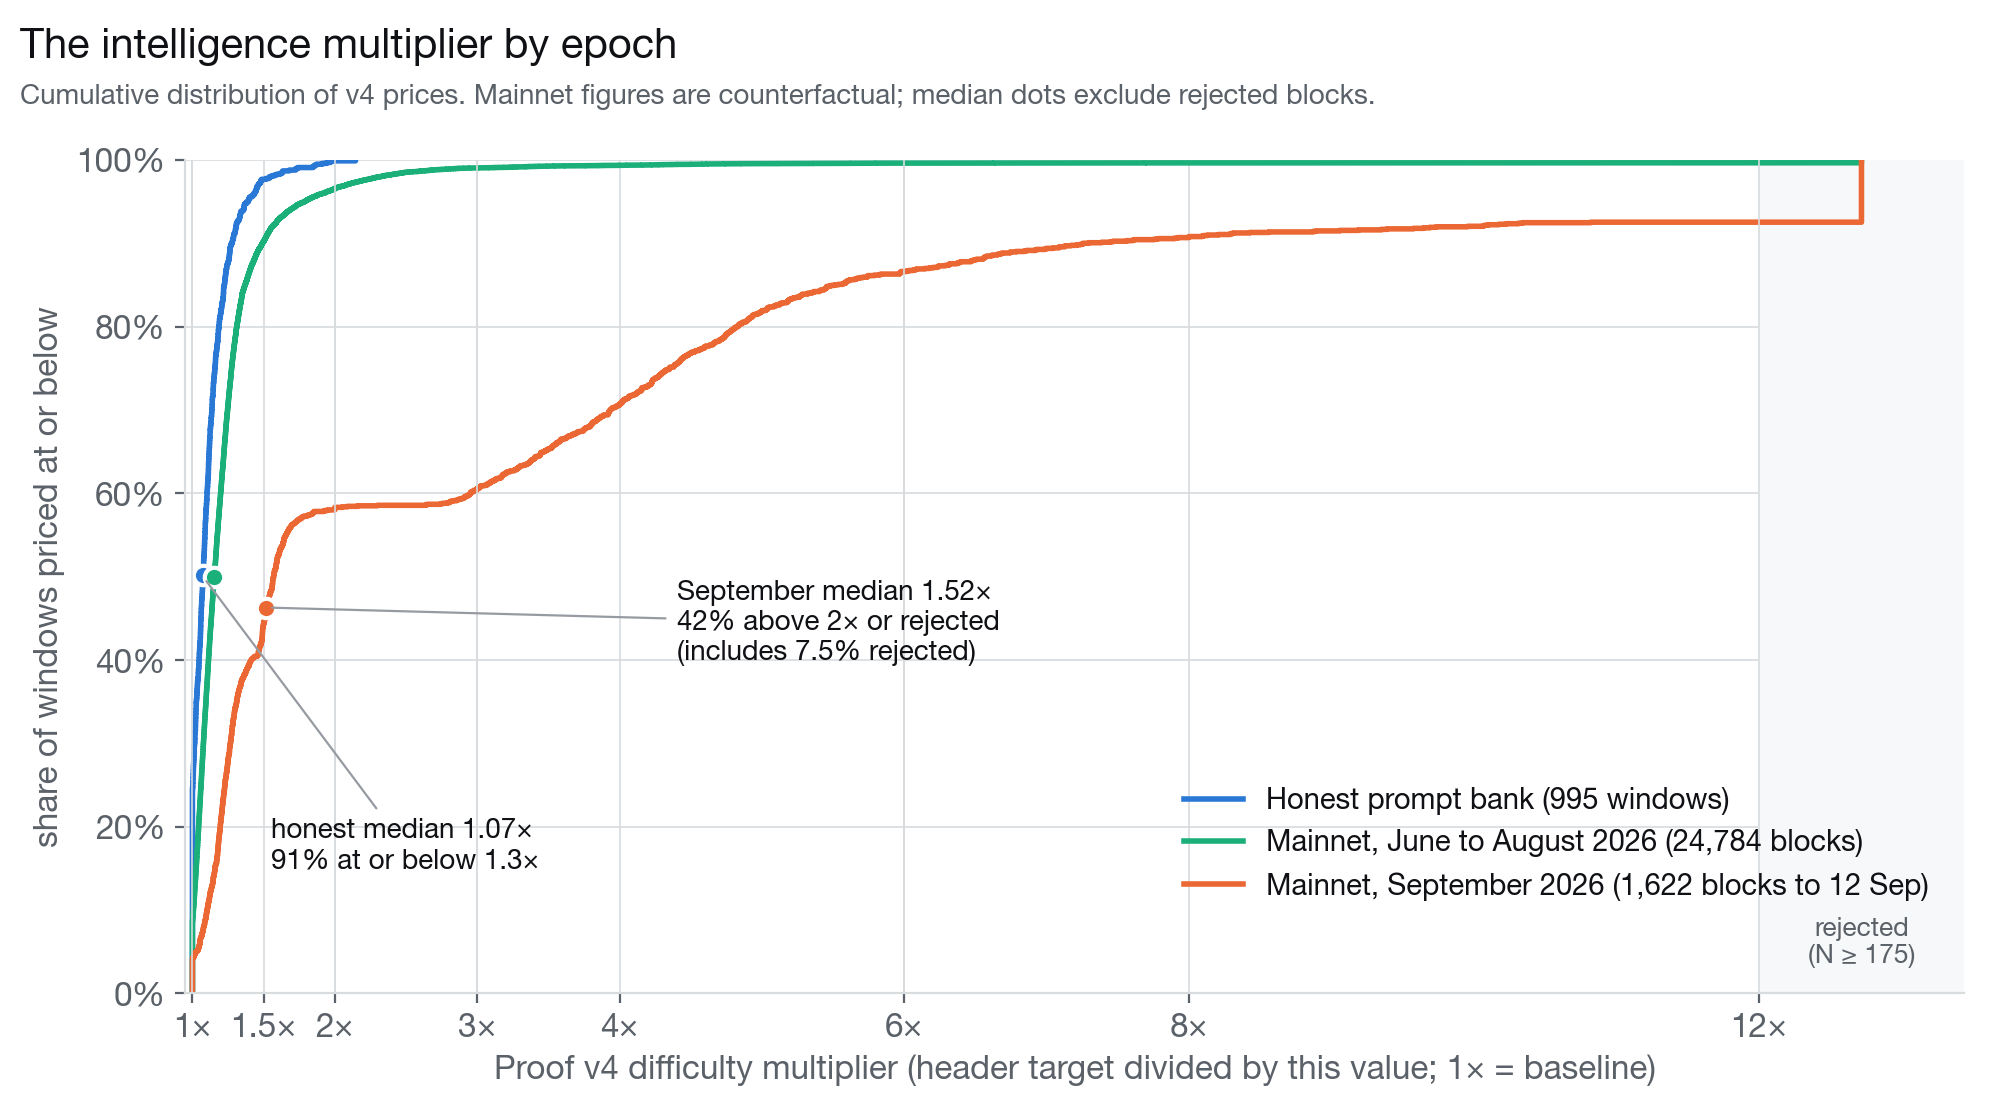
诚实样本库的结果接近基准水平。倍率中位数约为 1.07×,91% 的窗口不超过 1.3×。 最高倍率为 2.15×,v4 规则没有额外拒绝任何窗口。按样本库中实测的窗口构成估算, 在网络难度调整之前,区块头工作量约增加 10%。
不同时期的主网样本则存在明显差异:
| 样本范围 | 倍率中位数 | 超过 2× 或被拒绝 | 被拒绝 |
|---|---|---|---|
| 6 月至 8 月:24,784 个区块 | 1.15× | 3.4% | 0.3% |
| 9 月截至 12 日:1,622 个区块 | 1.52× | 42% | 7.5% |
中位数不包括被拒绝的区块。「超过 2× 或被拒绝」一栏已包含被拒绝的区块。
这些结果表明,对于样本库所涵盖的任务,成本增幅较小;而对 9 月主网样本的影响则明显更大。
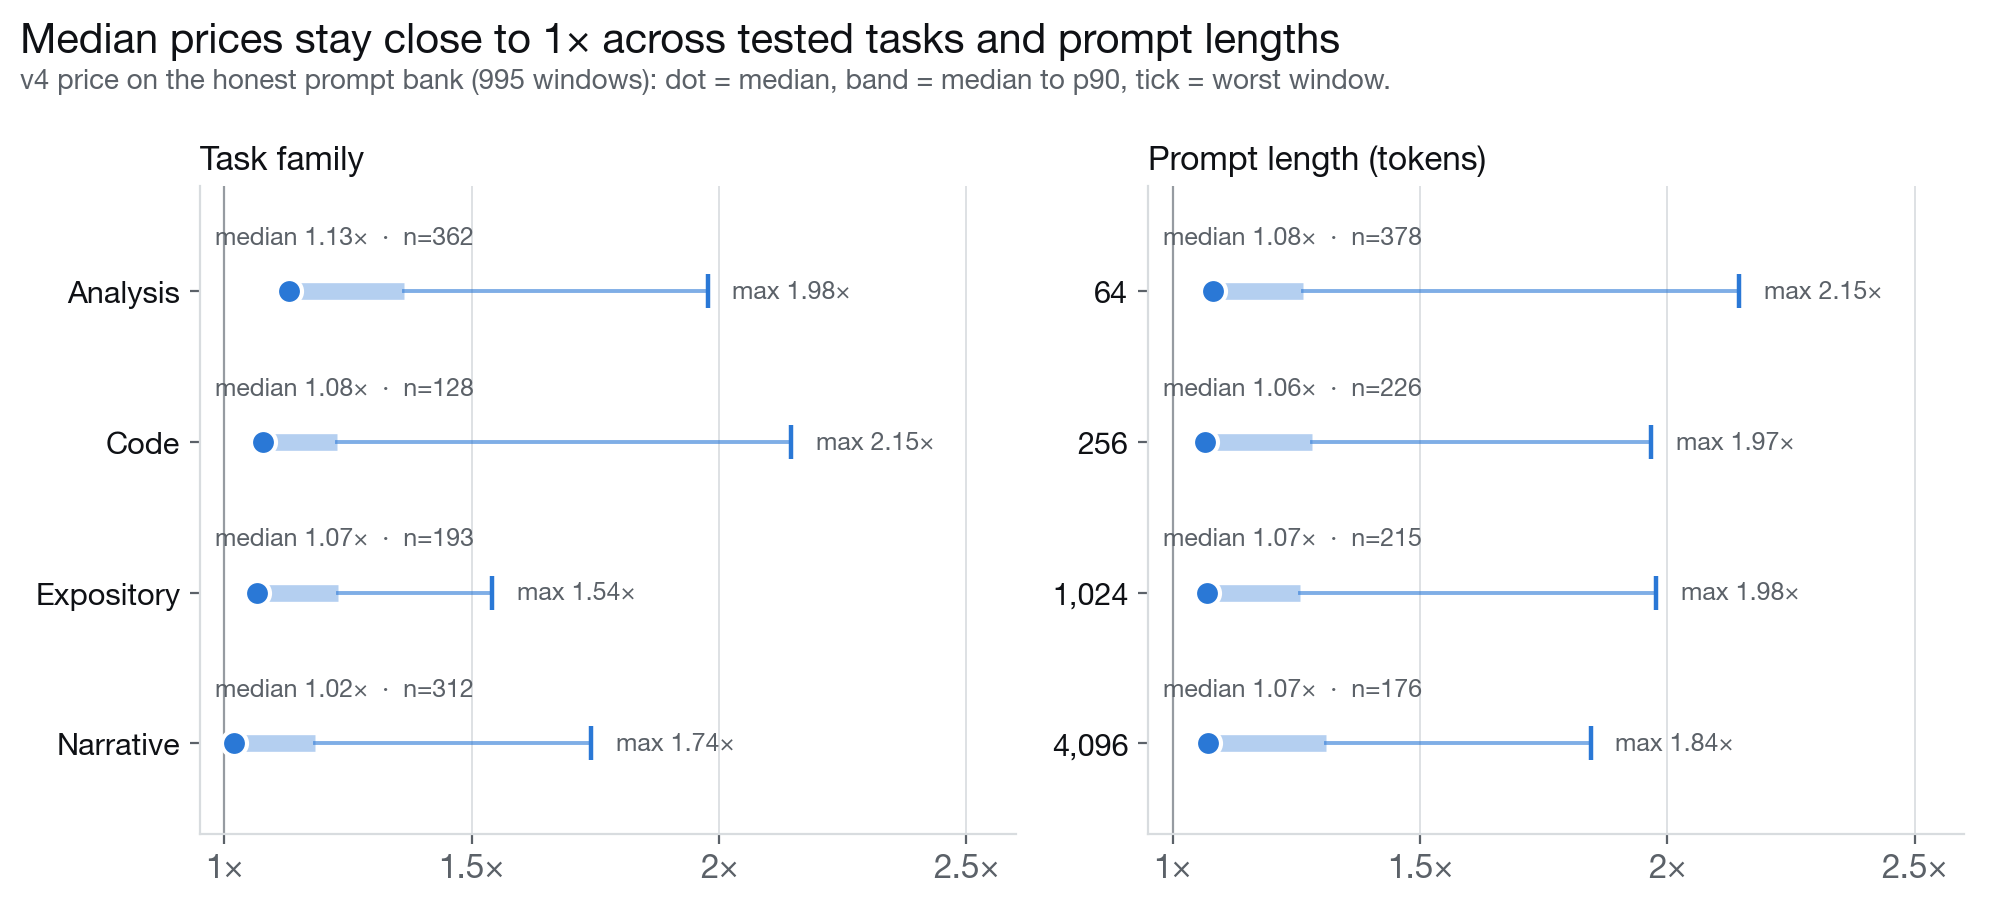
在所测试的任务类型和提示词长度范围内,倍率中位数都接近 1×。分析任务的中位数最高,为 1.13×。 在这批样本中,分析任务的窗口往往在生成过程较晚的阶段累积更多积分。
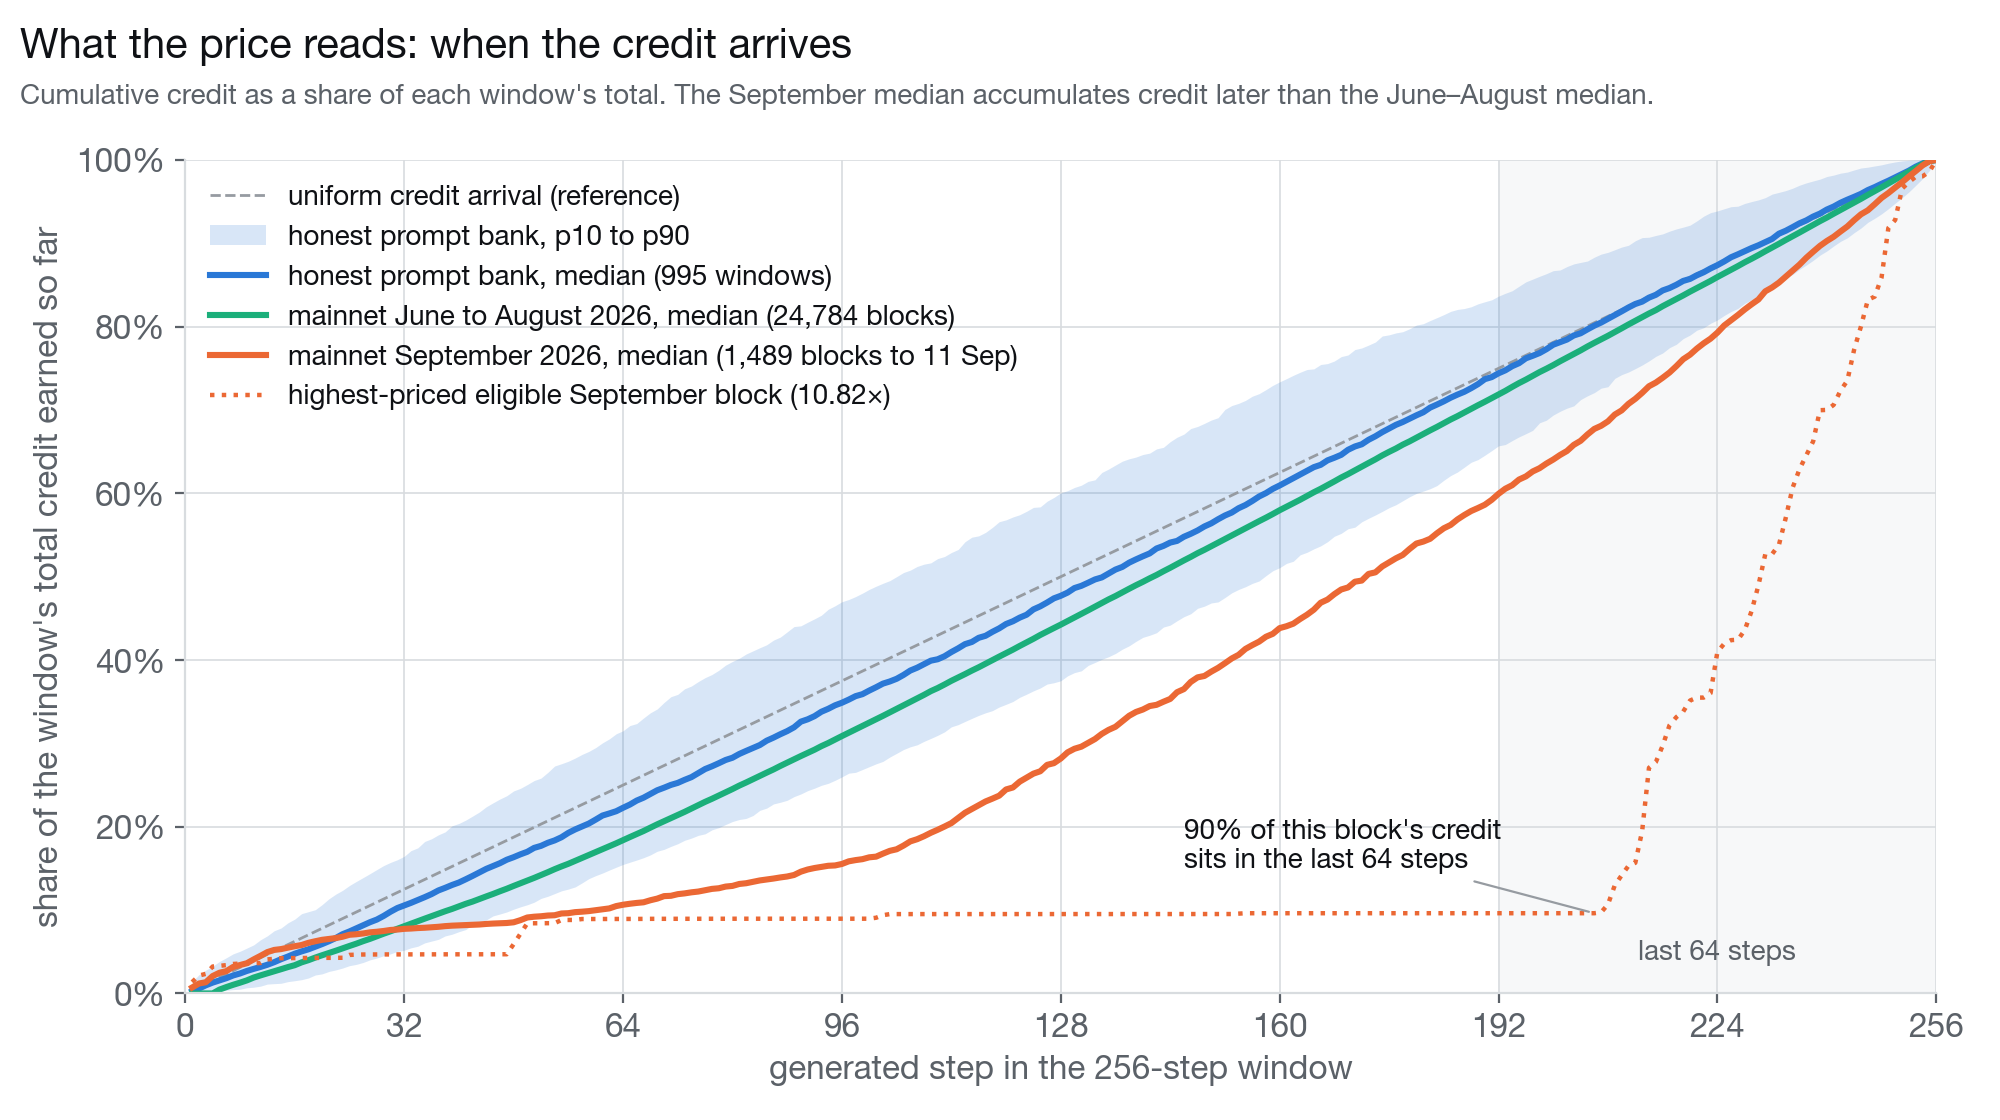
积分累积曲线有助于解释不同时期之间的差异。
诚实样本库和 6 月至 8 月的主网样本,积分累积相对平稳。到第 192 步时,6 月至 8 月的中位数曲线 已达到总积分的约 72%,而 9 月的中位数曲线只达到约 60%。
在 9 月按新规则仍可接受的区块中,倍率最高的那个区块将 90% 的积分集中在了最后 64 步。
这张图中的 9 月样本覆盖截至 9 月 11 日的 1,489 个区块,因为逐步积分数据的采集截止时间更早。 上面的定价结果则覆盖截至 9 月 12 日的 1,622 个 9 月区块。
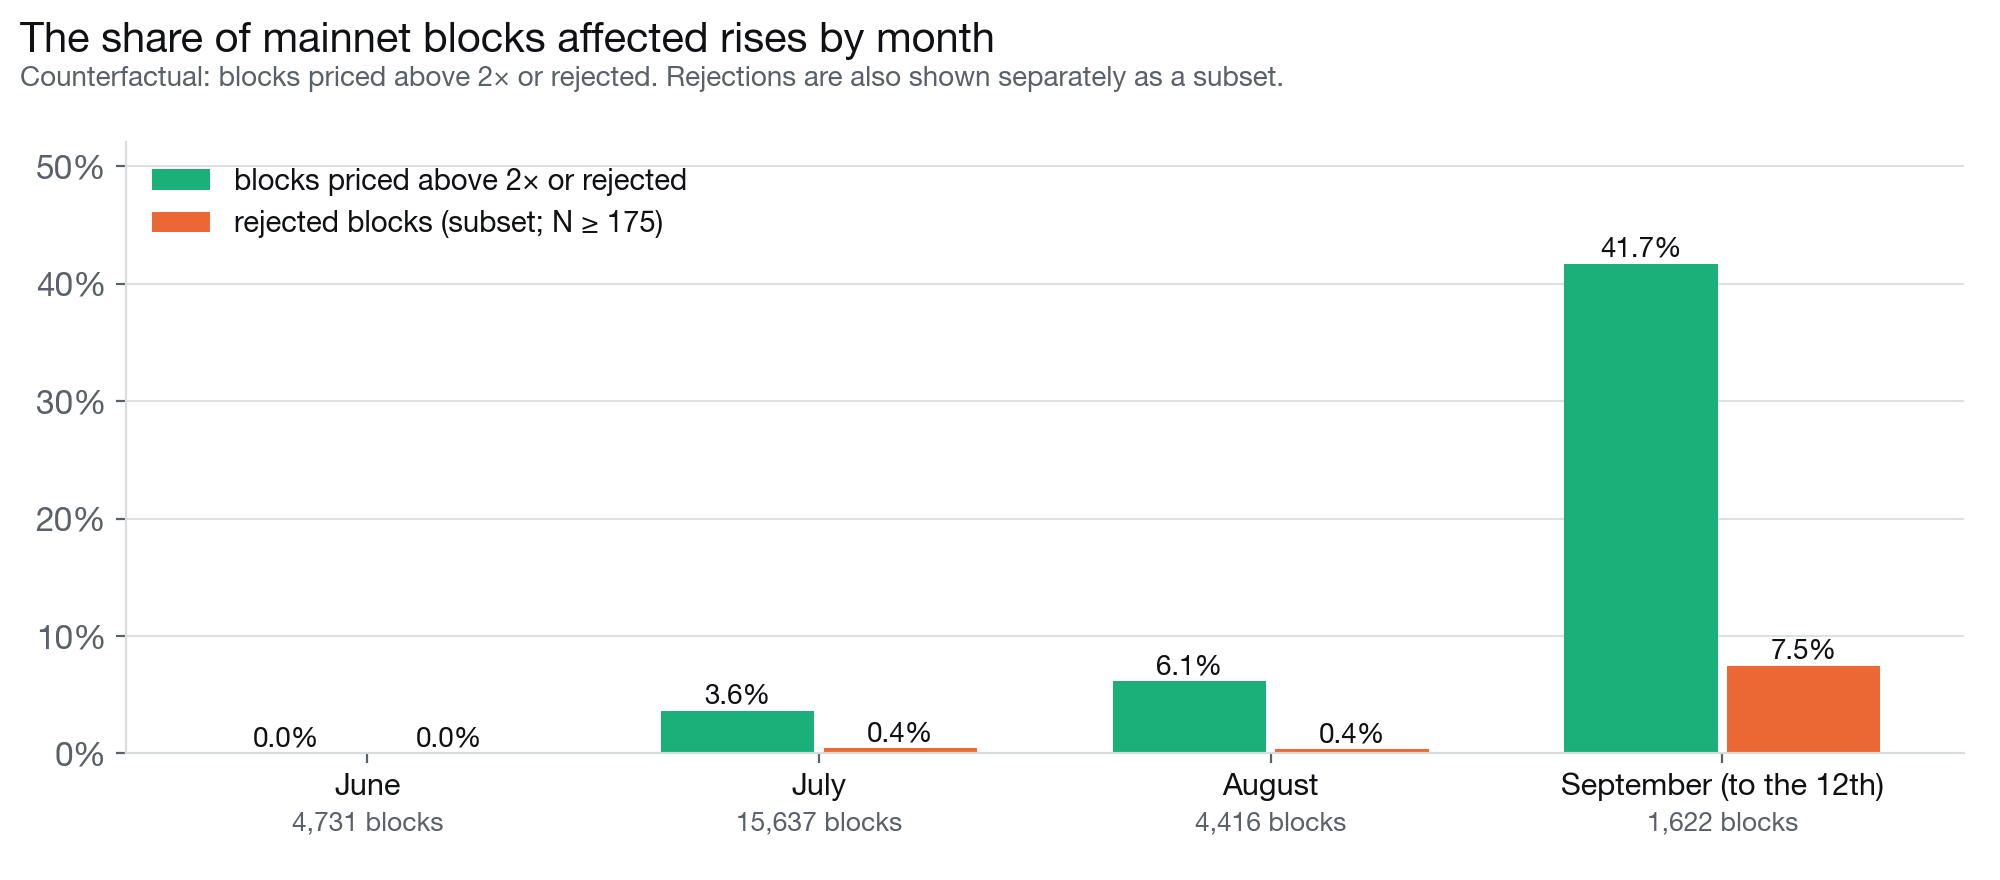
逐月比较能看出变化的幅度。6 月的 4,731 个区块中,只有一个会超过 2×,没有区块会被拒绝。 到了 9 月,42% 的区块会超过 2× 或被拒绝。
这正是智能倍率旨在作出的区分:积分到来较晚或高度集中的生成模式,需要承担更高的成本。
计划中的升级分为三个激活高度:
- 升级。 节点和验证者完成升级,网络开始同时接受 v4 和 v3 证明。
- 定价。 智能倍率同时适用于 v3 和 v4 证明。基准难度会一次性下调,以帮助抵消预期工作量的增加。
- 结束过渡。 网络不再接受 v3 证明。
除了智能倍率,proof v4 还包括:
- Gumbel 竞赛采样。 每一步都使用可复现的噪声,通过一次竞赛选出 token。
- 与 Argon 绑定的采样和结果哈希。 每次采样和最终哈希都与内存硬计算的输出绑定, 提高通过反复试探寻找有利结果(grinding)的难度。
- 提示词与续写复用检查。 协议检查重复的提示词,以及受保护续写片段的复用。
- 更严格的验证。 更新后的检查会验证采样过程,并应用该区块所处激活阶段的规则。
未来若推出 proof v5,将探索延迟与上下文问题。这两类问题在 UTXO 链上更难处理,仍需要进一步研究。
本文由 Imosuke Takakuni 以化名撰写。